Engenharia de contexto: o que é e por que decide a resposta do agente
Engenharia de contexto decide o que um agente de IA vê antes de responder: prompt, ferramentas, memória e base de conhecimento. Veja os cinco ingredientes.
Neste artigo
Dois agentes usam o mesmo prompt, o mesmo modelo, a mesma tarefa. Um responde certo. O outro inventa um preço que não existe ou esquece uma regra que a empresa mudou semana passada. A diferença quase nunca está no prompt. Está no que cada um tinha disponível na hora de responder: qual trecho da base de conhecimento entrou, se a conversa anterior foi lembrada, se a ferramenta certa estava carregada. Isso tem nome: engenharia de contexto.
O que é engenharia de contexto
Engenharia de contexto é a prática de decidir, pra cada resposta, o que exatamente entra na janela do agente: instruções, ferramentas, documentos recuperados, memória e histórico recente. Não é escrever uma instrução melhor. É montar o pacote de informação certo, do tamanho certo, na hora certa.
A diferença pra prompt engineering é de escopo. Prompt engineering resolve uma pergunta: como escrever a instrução? Engenharia de contexto resolve outra, maior: o que o modelo precisa enxergar pra essa instrução funcionar? Um prompt perfeito com contexto errado ainda erra a resposta. Um prompt simples com contexto certo, na maioria das vezes, acerta.
Os cinco ingredientes que formam o contexto de um agente
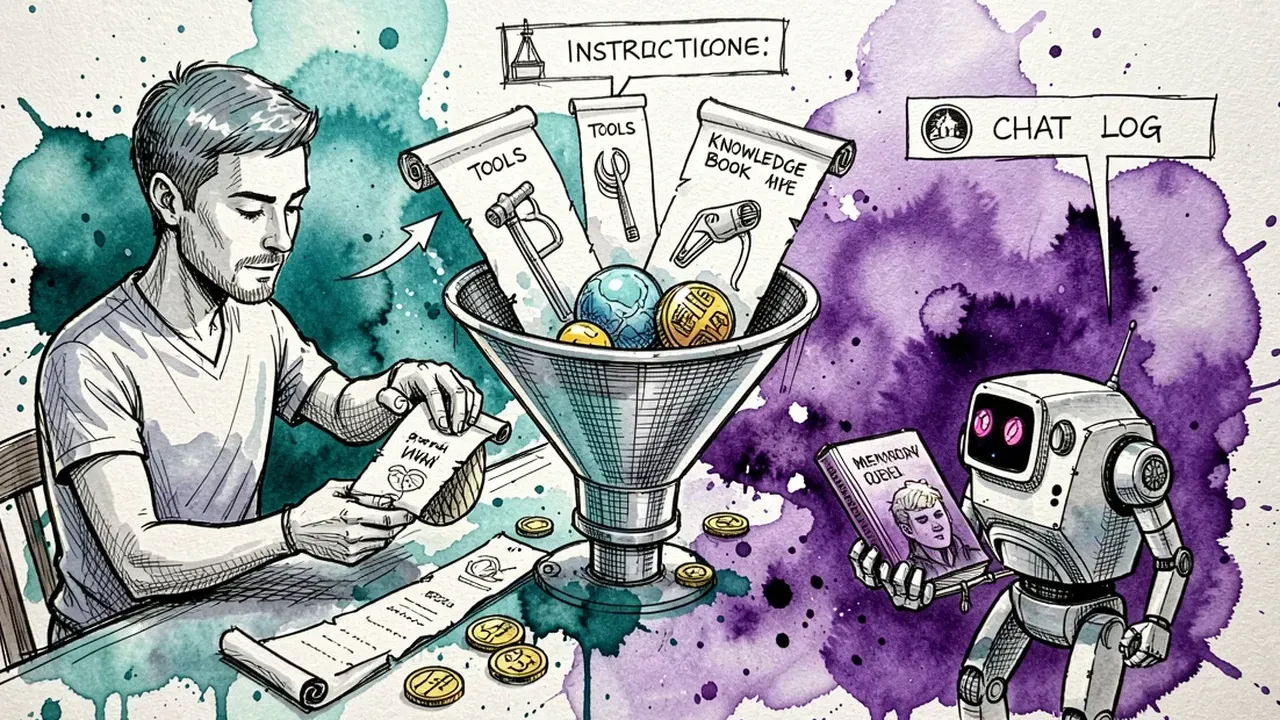
Contexto não é uma coisa só. São cinco camadas diferentes, e cada agente decide quanto de cada uma carregar em cada resposta.
| Ingrediente | O que é | Risco se faltar |
|---|---|---|
| Instruções (system prompt) | Papel, tom e regras fixas do agente | Agente sem personalidade nem limite |
| Ferramentas disponíveis | O que o agente pode fazer: consultar CRM, abrir ticket, calcular | Promete o que não consegue cumprir |
| Base de conhecimento | Documentos, políticas e FAQ recuperados na hora | Resposta genérica ou desatualizada |
| Memória | Fatos sobre aquela pessoa específica, de conversas passadas | Cliente tem que se repetir a cada contato |
| Histórico da conversa | O que foi dito nesta sessão, até agora | Agente esquece o que o próprio usuário acabou de dizer |
Um agente bom não usa as cinco camadas com o mesmo peso o tempo todo. Ele decide, pergunta a pergunta, quanto de cada uma vale a pena carregar. É aí que mora o trabalho de verdade.
Por que contexto errado quebra mais agente do que prompt fraco
O prompt aparece pro time que constrói o agente, revisado com calma antes de publicar. O contexto aparece, ou falta, só na hora da resposta, com o cliente do outro lado. Isso torna o erro mais caro e bem mais difícil de pegar em teste.
Três jeitos comuns de dar errado:
Contexto genérico pra todo mundo. O mesmo bloco de política entra em toda resposta, mesmo quando 90% dele não tem nada a ver com a pergunta feita. O modelo gasta atenção, e tokens, em texto irrelevante, e a resposta fica mais vaga, não mais precisa.
Contexto poluído. Documento desatualizado, ticket antigo já resolvido, trecho de conversa sem relação com o problema atual. Cada peça irrelevante compete por atenção com a peça que realmente importa pra aquela resposta.
Contexto que não existe. A pergunta do cliente exige um dado (preço atual, status de um pedido, política que mudou semana passada) e o agente não tem acesso a isso na hora. Ele então completa o buraco com o que parece plausível. É a alucinação nascendo de uma falha de contexto, não de um modelo ruim.
Como montar o contexto certo pra cada resposta
Regra prática: pergunte, pra cada resposta, o que precisa estar ali pra ela sair certa. Não o que seria legal ter.
- Recuperação seletiva, não despejo. Buscar na base de conhecimento os trechos relevantes pra aquela pergunta específica, não o manual inteiro. RAG bem feito filtra antes de entregar, não depois.
- Resumir, não acumular. Conversa longa não precisa entrar verbatim inteira. Um resumo do que já foi dito, mais o trecho recente literal, cobre o mesmo terreno com bem menos ruído.
- Priorizar quando o espaço aperta. Nem tudo cabe na janela. O que decide a resposta (dado do cliente, regra da empresa) vem antes do que só enriquece (histórico antigo, contexto de nicho).
- Atualizar a fonte, não só o prompt. Se o agente errou porque a política mudou, o conserto é atualizar a base de conhecimento. Reescrever a instrução pra “lembrar” o agente toda vez não escala.
Contexto também é custo
Cada trecho que entra na janela custa token, e token custa dinheiro a cada execução. Empurrar o documento inteiro “pra garantir” não deixa o agente mais seguro. Deixa mais caro e, na prática, menos preciso: o modelo tem que separar sinal de ruído no meio de texto que não precisava estar ali.
A conta muda de figura numa plataforma multimodelo, onde dá pra rodar a etapa de recuperação num modelo barato e reservar o modelo caro só pra gerar a resposta final. É esse tipo de escolha, feita execução a execução, que separa uma operação de IA cara de uma que escala.
Montar o contexto certo fica mais fácil quando a plataforma já resolve multimodal com economia de token embutida e deixa trocar de modelo por tarefa. O SquadOS roda 30 modelos de 15 provedores, com até 95% de economia em tokens e BYOK pra usar sua própria chave.